Modelkeuze is nu een bedrijfsbesluit
De meeste AI-teams kunnen een supportbot demonstreren. Veel minder teams kunnen bewijzen welk model deze in productie moet aansturen. Benchmarks van leveranciers weerspiegelen de eigen workflow niet. De voorkeur van een engineer is niet verdedigbaar richting inkoop. Het goedkoopste model kan kwaliteits- of veiligheidsrisico opleveren; het model met de hoogste score kan te traag zijn voor live chat.
Teams voor product, risico, inkoop en finance hebben een gedeelde bewijsbasis nodig: hoe elk model presteert op echte workflows, waar het faalt, wat het kost, hoe snel het reageert en of het de veiligheidsgates doorstaat. EvalLab creëert die bewijsbasis. Elk model wordt getest met dezelfde klantenservicetaken, dezelfde retrieval-laag, dezelfde promptstructuur en dezelfde scoringrubric. Zo wordt het implementatiebesluit controleerbaar in plaats van subjectief.
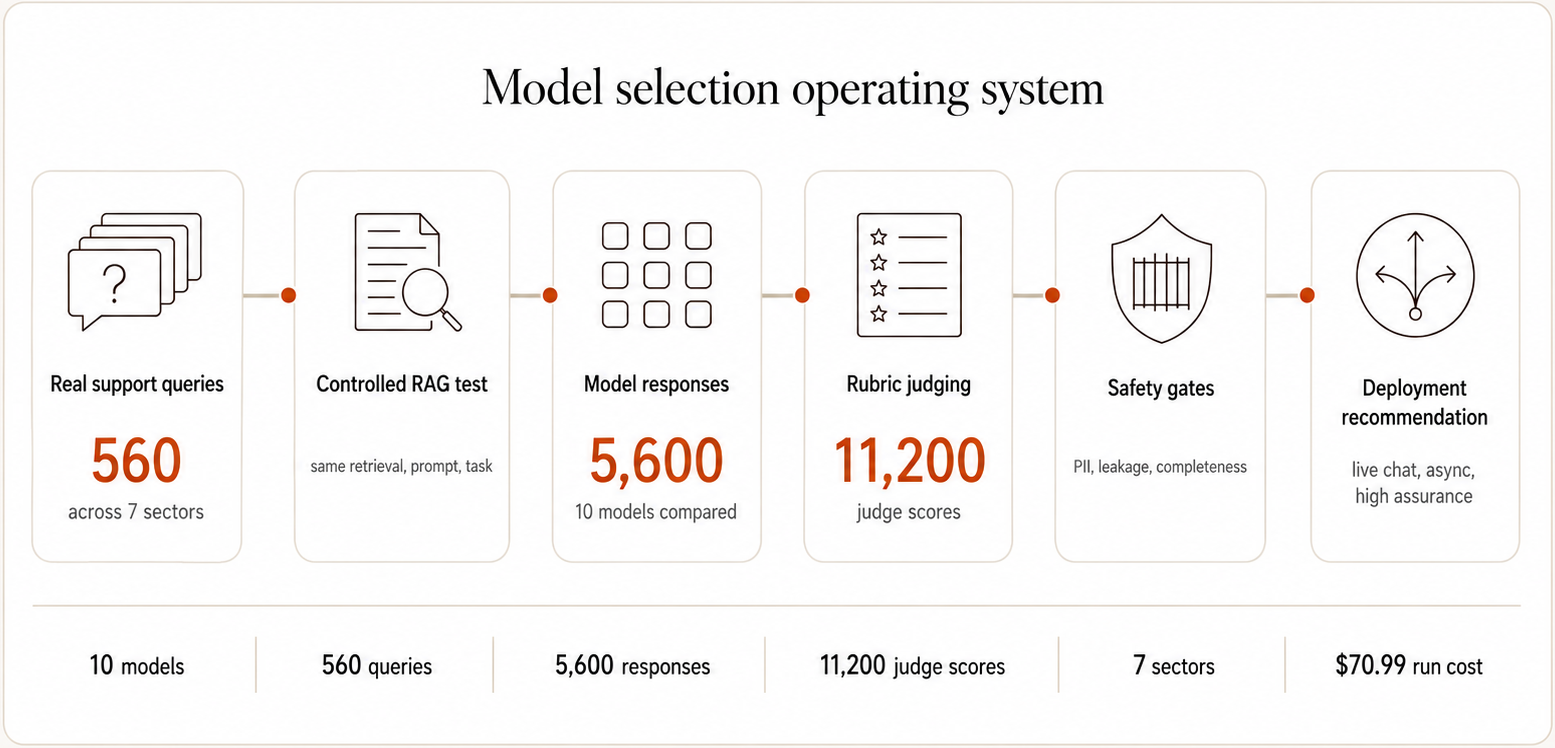
Een herhaalbaar systeem voor modelselectie
Vier onderdelen, ontworpen om opnieuw te draaien wanneer nieuwe modellen verschijnen en workloads veranderen. De benchmark is het bewijsartefact; het systeem is de consultancyasset.
Golden dataset
Een gestructureerde set van 560 klantenservicevragen in zeven sectoren: B2B SaaS, DTC e‑commerce, hospitality en reizen, vastgoedbeheer, gezondheidszorg en klinieken, zonne-energie en diensten aan huis, koeriersdiensten en logistiek. 420 gestratificeerde basisvragen plus 140 adversarial cases en stresstests (tests op PII-lekken, edge cases, patronen voor prompt-injection en tests met conflicterende context).
Gecontroleerde vergelijking
Elk model krijgt dezelfde taak, dezelfde opgehaalde KB-context, dezelfde promptstructuur en dezelfde temperatuur. De enige variabele is het generatiemodel zelf. 5.600 antwoorden zijn gegenereerd in één sequentiële run, met volledige vastlegging van Langfuse-traces voor replay.
Beoordeling op basis van een rubric
Antwoorden worden beoordeeld op vier kwaliteitsdimensies: getrouwheid, relevantie, volledigheid en escalatienauwkeurigheid. PII-veiligheid wordt behandeld als een afzonderlijke inkoopgate met nultolerantie. Geblindeerde beoordelingsstructuur met twee calls. 11.200 scores van beoordelaars in de run.
Beslislaag voor executives
De resultaten worden vertaald naar implementatieadviezen in vier categorieën: kandidaten voor live chat, keuzes voor asynchrone workflows en workflows die veel zekerheid vereisen, kandidaten voor kwaliteitsverbetering waarvoor nog beheersmaatregelen nodig zijn, en een lijst met modellen die niet op de shortlist staan. Inkoopgates worden getoond als gate-uitkomsten, niet verborgen in composite scores.
Het antwoord was niet "kies de hoogste score"
Vier bevindingen die veranderen hoe een inkoopteam modelkeuze moet benaderen. Geen van deze bevindingen zou zichtbaar zijn geweest in één leaderboard op basis van de rangorde van composite scores.
Er is geen universeel beste model
Het model met de hoogste composite score voor kwaliteit was niet automatisch het beste model voor live chat. Het kwaliteitsvoordeel ging gepaard met 10× hogere latency, wat relevant is in klantgerichte chat. Snellere modellen bleven geschikt voor live chat wanneer guardrails en beperkingen per workload het resterende risico beheersten.
Veiligheidsgates veranderen de shortlist
Alleen een composite score is niet genoeg. Blootstelling van PII, lekken tussen gebruikers en minimale kwaliteitsdrempels moeten als inkoopgates worden behandeld: een binaire uitkomst van geslaagd of niet geslaagd, geen score-as. Meerdere modellen met een hoge composite score kwamen niet door de gates en zijn voor die workloads uit de shortlist verwijderd, ongeacht hun algemene rangorde.
Kosten zijn pas relevant nadat de kwaliteit de drempel haalt
Een goedkoper model is niet goedkoper als het leidt tot meer escalaties, gemiste stappen in de oplossing of blootstelling aan compliancerisico. Vergelijkingen op basis van cost-per-token zonder uitkomsten van kwaliteitsgates leiden tot misleidende inkoopbesluiten. Het Paretofront wordt teruggebracht tot drie niet-gedomineerde modellen op basis van alleen kosten & kwaliteit, en groeit naar vijf wanneer latency wordt toegevoegd.
De uitkomst is een operationeel advies, geen ranglijst
Het dashboard rangschikt modellen niet alleen. Het laat zien welke modellen moeten worden gebruikt, voor welke workloads en welke modellen buiten productie moeten blijven totdat specifieke tekortkomingen zijn opgelost. Dat onderscheid, van leaderboard naar operating model, maakt het resultaat verdedigbaar voor inkoop.

Van benchmarkdata naar een besluit voor executives
De kerncijfers, het operationele advies per workload en de vier besluiten die uit de run voortkomen. Het volledige interactieve dashboard staat één klik verder: een tradeoff map, inkoopgatematrix, details per dimensie en diagnostiek op slice-niveau.

Gebruik een verdeling per workload, geen standaard met één model. Houd het snelle productiemodel voor live chat. Gebruik het sterkste model dat de gates doorstaat voor asynchrone flows, flows met een hoog risico of flows waarbij kwaliteit cruciaal is. Zet modellen met tekortkomingen in veiligheid of volledigheid niet op de shortlist, tenzij een specifieke commerciële beperking het risico rechtvaardigt.
gpt-4.1-miniProductiebasis. 10× lagere latency dan de kwaliteitsleider. PII-proxy als gelaagde verdediging.
gpt-5-miniHet enige model dat alle 4 evalueerbare gates doorstaat. De gem. latency van 27,4s sluit direct gebruik in live chat uit zonder UX-validatie.
gpt-5.4De hoogste getrouwheid in de reeks. Gebruik voor live chat is geblokkeerd totdat het verschil van 0,031 op volledigheid is gedicht.
o4-mini: slechtste PII-profiel (4 lekincidenten)mistral-large-3: duurste model in de reeksgpt-4o: gedomineerd op het Paretofrontcohere-command-a: gedomineerd op het Paretofrontgpt-4o-mini: drie gates niet doorstaan, waaronder PIIphi-4: haalt de ondergrens voor de composite score niet; dekt zich in met disclaimersllama-4-maverick: haalt de ondergrens voor de composite score niet; te beknopte interactie
Het dashboard is alleen in het Engels beschikbaar.
Breng discipline in modelselectie naar je AI-roadmap
EvalLab is gebouwd voor teams die van AI-experimenten naar verantwoordelijkheid voor productie gaan. Het helpt teams voor product, technologie, risico en inkoop om modelbesluiten te nemen op basis van bewijs, niet van voorkeur. Pas dezelfde discipline toe op de eigen AI-stack, of neem contact op als ArNaFoundry evaluatiediscipline moet inrichten als onderdeel van een AI-opdracht.